
Mantener y proteger
Qué hacer cuando tu web se cae: monitoreo y respuesta
Cuando tu web deja de responder, los primeros minutos se pierden preguntando quién sabe qué hacer. Esta guía propone una secuencia simple: detectar, verificar, comunicar, escalar y cerrar, con roles claros y un registro del incidente, sin depender de promesas que tu contrato no incluye.
En esta guía
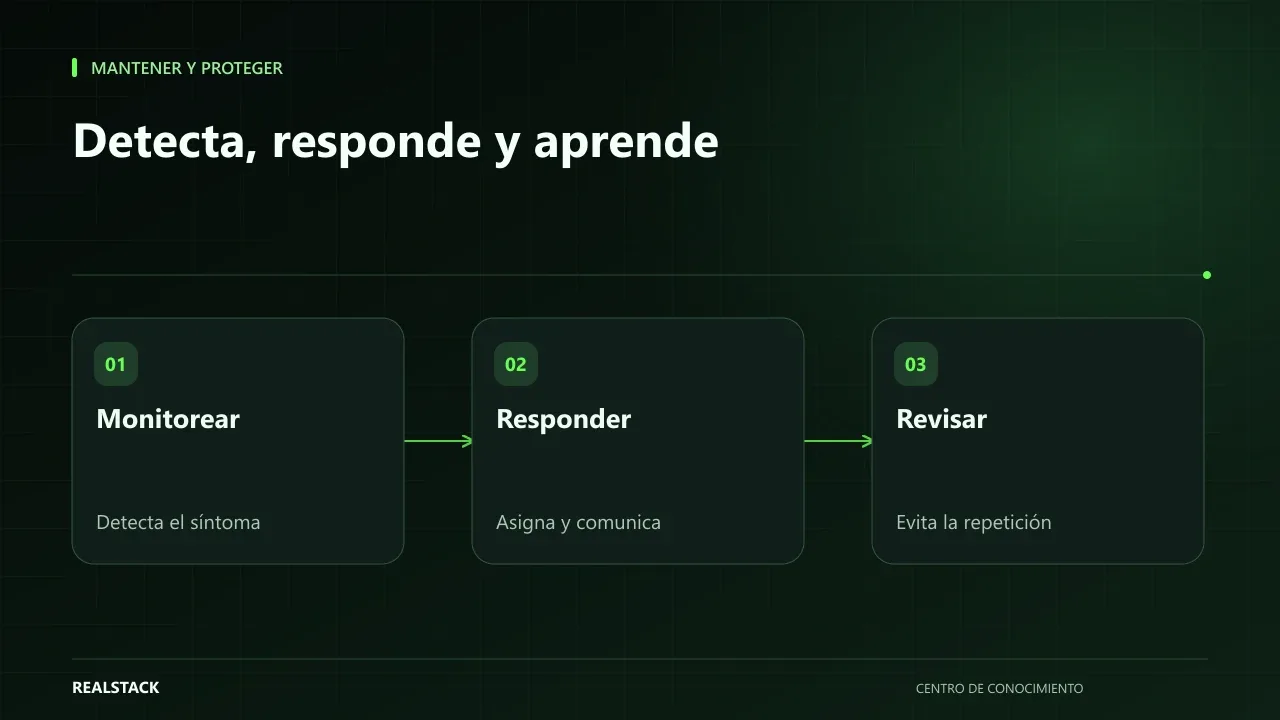
El cliente avisa primero
Un cliente escribe por WhatsApp: «no me abre la página». Alguien lo prueba en su celular, otro en el computador, alguien llama al proveedor, otro busca la clave del hosting. Media hora después nadie sabe todavía si es el dominio, el servidor o una actualización. Una caída no se puede evitar siempre, pero el desorden sí.
Detectar antes que el cliente
Un monitoreo básico revisa cada pocos minutos que tu sitio responda y avisa si no lo hace. El libro de SRE de Google recomienda que las alertas se basen en síntomas que afectan al usuario, como que el sitio no responda o responda con errores, y no en cualquier métrica interna. Define quién recibe la alerta y por qué canal.
Cinco pasos
- Detectar: llega una alerta o un aviso de cliente. Anota la hora.
- Verificar: comprueba desde otra conexión y otro dispositivo. Anota qué se ve: página en blanco, error de certificado, código de error HTTP como 500 o 503, o el dominio no resuelve.
- Comunicar: avisa internamente que hay un incidente y quién lo coordina. Si afecta a clientes, prepara un mensaje breve y honesto.
- Escalar: contacta al responsable técnico o proveedor según tu contrato, con lo verificado. Si no responde en el tiempo acordado, sigue la lista de escalado.
- Cerrar: cuando se restablece, verifica que funciona, anota la hora y programa la revisión posterior.
Roles
| Rol | Responsabilidad |
|---|---|
| Coordinador | Decide, registra y mantiene informado al resto |
| Técnico | Diagnostica y corrige, o gestiona al proveedor |
| Comunicación | Habla con clientes y equipo interno |
En una empresa pequeña, una persona puede cubrir dos roles. Lo importante es que esté claro antes del incidente, como recomienda la gestión de incidentes del libro de SRE.
Qué decir a los clientes
No prometas una hora de solución que no controlas.
Revisión posterior
Después del incidente, escribe qué pasó, cuándo se detectó, qué se hizo y qué se puede mejorar. La cultura de postmortem sin culpables busca aprender, no señalar a una persona.
Monitoreo y contratos
Los tiempos de respuesta y de solución que puedes exigir son los que dice tu contrato. En RealStack, Continuity trabaja con un objetivo de disponibilidad del 99,0 % para Web, App y Sistema. Es un objetivo, no un SLA universal, y no cubre infraestructura propia del cliente; la cobertura concreta es la del plan vigente. Ningún servicio puede garantizar que un sitio nunca se caiga.
Ejemplo aplicado
Cómo usar la checklist descargable
- Llena la preparación antes de cualquier incidente.
- Durante el incidente, marca cada paso con su hora.
- Al cerrar, completa la revisión posterior.
Criterios de severidad
| Nivel | Situación | Respuesta |
|---|---|---|
| Alta | El sitio o el sistema no está disponible o no permite vender | Activar el procedimiento completo y avisar a clientes |
| Media | Una función importante falla, pero hay alternativa | Atender en el mismo día y avisar si afecta a clientes |
| Baja | Fallo menor sin efecto en la operación | Programar la corrección |
Ejemplo sintético completo
Ejemplo sintético. Un martes a las 10:05, el monitoreo de una empresa ficticia avisa que su tienda no responde. La persona de guardia confirma desde otra red a las 10:08 y abre el registro del incidente.
A las 10:12 el responsable técnico identifica que el certificado venció: la renovación automática había fallado sin aviso. A las 10:15 la persona de comunicación publica en redes y en WhatsApp un mensaje breve: la tienda presenta una falla, se está atendiendo y los pedidos se pueden hacer por teléfono. A las 10:40 el certificado está renovado y la tienda responde. A las 10:50 se confirma que los pagos funcionan y se publica que el servicio está restablecido.
En la revisión posterior, el equipo acuerda configurar un aviso de vencimiento del certificado con 30 días de anticipación a un correo compartido. Ejemplo inventado.
Errores frecuentes, explicados
Esperar a tener la causa antes de avisar a los clientes genera más llamadas y desconfianza. Un aviso breve, honesto y sin promesas de hora es mejor que el silencio. Y cerrar el incidente sin revisión posterior garantiza que se repita: la revisión no busca culpables, busca la acción que evita la siguiente caída.
Cómo saber si funcionó
- El monitoreo avisa antes que los clientes.
- Cada rol sabe qué hacer.
- Cada incidente tiene revisión posterior.
Plan para las primeras cuatro semanas
- Semana 1: activa monitoreo externo.
- Semana 2: asigna roles y escalado.
- Semana 3: prepara mensajes para clientes.
- Semana 4: simula un incidente.
Diagnóstico antes de empezar
- Pregunta quién se entera hoy si la web se cae y cómo.
- Revisa si tienes el contacto de soporte del proveedor.
- Busca si hay un mensaje preparado para clientes.
| Si tu caso es… | Haz esto |
|---|---|
| No hay monitoreo | Activa uno externo con alertas a dos personas. |
| Hay monitoreo, pero sin roles | Asigna quién confirma, quién arregla y quién comunica. |
| La caída depende de un proveedor | Ten su escalado documentado. |
Un segundo ejemplo, en contraste
Ejemplo sintético. Una empresa ficticia detecta una caída a medianoche; como su tienda vende poco de noche, decide no activar el procedimiento completo y atenderla a primera hora. Fue una decisión válida porque tenía criterios de severidad escritos. A diferencia del primer ejemplo, no todo incidente exigía respuesta inmediata. Ejemplo inventado.
Qué hacer cuando algo falla
- Si no logras restablecer, comunica avances cada cierto tiempo sin prometer horas.
- Si la causa es del proveedor, escala y documenta.
- Si se repite, prioriza la acción de la revisión posterior.
Cómo medirlo con tus propios datos
- Registra la hora de inicio, detección, aviso y restablecimiento de cada incidente.
- Anota quién detectó primero: el monitoreo, el equipo o un cliente.
- Cuenta cuántas acciones de la revisión posterior se completaron.
- Compara los tiempos de detección entre incidentes.
Con esos registros puedes calcular tus propios tiempos de detección y de restablecimiento sin depender de cifras externas. Si el monitoreo detecta antes que los clientes y los tiempos bajan con cada revisión, el procedimiento funciona. Si un mismo tipo de incidente se repite, la acción acordada en la revisión no se completó o no atacaba la causa.
Errores frecuentes
- Enterarse por los clientes.
- No anotar horas ni lo verificado.
- Varias personas llamando al proveedor a la vez.
- Prometer horas de solución.
- No hacer la revisión posterior.
Checklist
- Monitoreo activo.
- Roles asignados.
- Escalado documentado.
- Mensaje para clientes listo.
- Revisión posterior hecha.
Llévalo a tu negocio
Checklist de respuesta ante una caída
Checklist en Markdown para responder a una caída del sitio: detectar, verificar, comunicar, escalar y cerrar, con roles, contactos de escalado, mensaje modelo y registro del incidente. No incluye accesos.
Ver recurso¿Qué tiempo de respuesta puedo exigir?
El que establece tu contrato o plan vigente. Si no está escrito, acuérdalo antes de que ocurra un incidente.
¿El plan de Continuity incluye créditos si se incumple la disponibilidad?
Las condiciones de cobertura y créditos son las del plan vigente. Consulta el documento del plan antes de contratar o reclamar.
¿Qué monitoreo necesito?
Como mínimo, una revisión externa de disponibilidad y del certificado con alertas a más de una persona.
¿Debo avisar a los clientes de todas las caídas?
De las que los afectan. Usa los criterios de severidad: un fallo menor sin efecto visible puede resolverse sin aviso público.
¿Qué incluye una revisión posterior?
Cronología, causa, efecto, qué funcionó, qué no y una acción con responsable y fecha. Su objetivo es evitar que se repita, no buscar culpables.
Sigue explorando
Mantener y proteger
Dominio, alojamiento, SSL y accesos: qué debe controlar tu empresa
Tu dominio, tu alojamiento, tus certificados y tus accesos son activos de la empresa, aunque los haya contratado un proveedor. Esta guía explica cómo saber a nombre de quién están, cuándo vencen, quién responde por ellos y cómo inventariarlos sin guardar contraseñas en una hoja.
Mantener y proteger
Mantenimiento web: qué exigir y cómo comprobarlo
«Mantenimiento web» puede significar cosas muy distintas según quién lo venda. Esta guía separa alojamiento, mantenimiento, soporte, garantía y evolución, explica qué exigir de cada uno según lo contratado y cómo comprobar que se está cumpliendo con evidencias concretas.